Hur fungerar ChatGPT när du skriver en fråga och får ett svar några sekunder senare? Din text sätts ihop med instruktioner och sammanhang, omvandlas till små textdelar och bearbetas av en språkmodell. Svaret byggs sedan upp steg för steg, ibland med hjälp av sökningar eller andra verktyg.
Det förklarar flera saker du kanske har märkt: varför en tydlig fråga ger ett bättre svar, varför en lång chatt kan tappa tråden och varför en övertygande formulering ändå kan innehålla fel. För ett företag som vill använda AI i vardagen är det användbar kunskap.
Hur fungerar ChatGPT, steg för steg?
Det hjälper att skilja på appen ChatGPT och språkmodellen bakom den. Appen tar emot meddelandet, hanterar samtalet och kopplar in funktioner. Modellen är den del som bearbetar underlaget och genererar innehåll. Liknande uppdelning finns i andra AI-tjänster.
| Steg | Vad som händer |
|---|---|
| 1. Sammanhang samlas | Frågan kombineras med instruktioner och relevant information från samtalet, filer eller andra källor. |
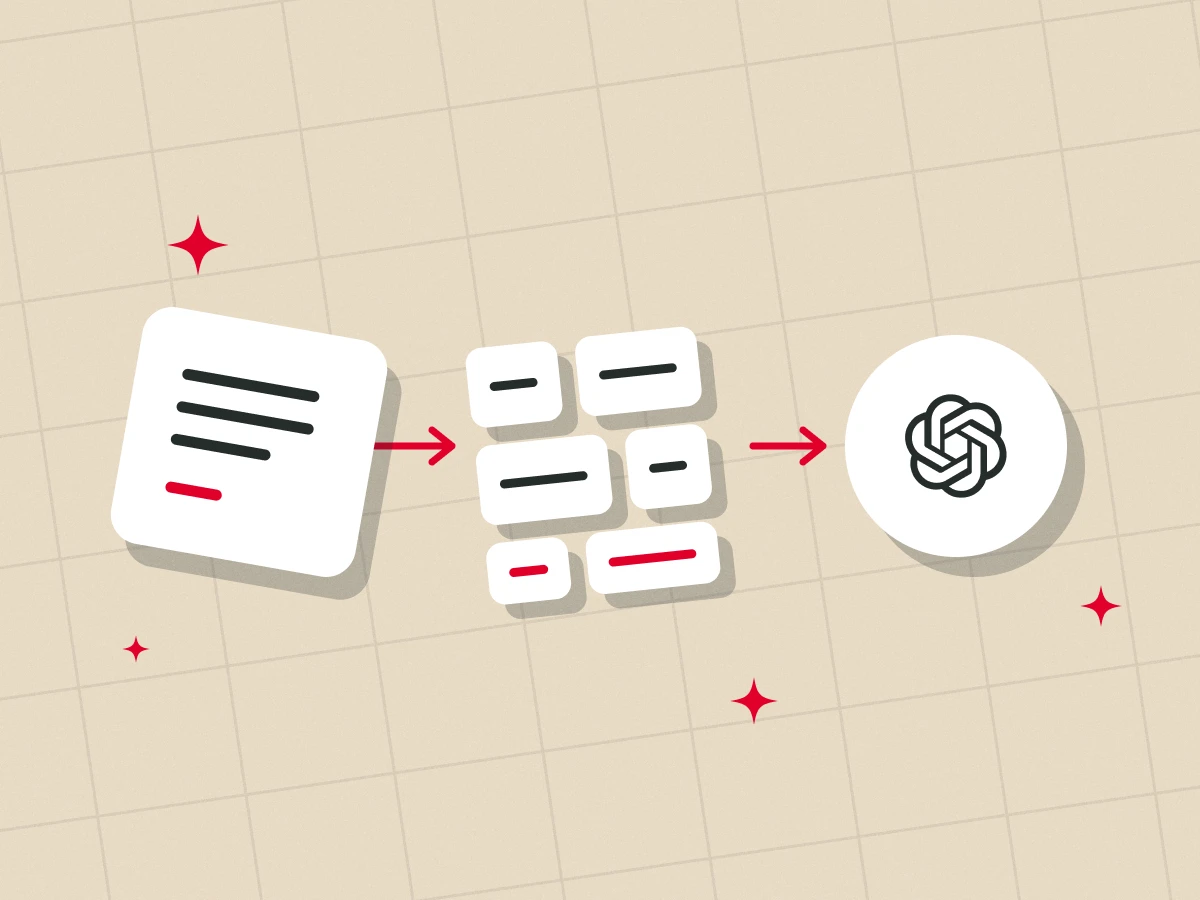
| 2. Texten delas upp | En tokenizer gör om texten till tokens som modellen kan bearbeta. |
| 3. Modellen räknar | Modellens lager bearbetar sambanden i underlaget och beräknar möjliga fortsättningar. |
| 4. Svaret växer fram | Texten genereras i en följd av tokens. Vissa uppgifter kräver ytterligare resonemang eller verktyg. |
| 5. Appen visar resultatet | Svaret skickas tillbaka till chatten, ofta medan det fortfarande genereras. |
Din fråga får sällskap av mer information
När du skriver en fråga är den sällan hela underlaget. Appen kan lägga till instruktioner om hur assistenten ska bete sig, dina egna inställningar och relevanta delar av tidigare meddelanden. Bifogade dokument, sparade minnen och hämtad information kan också bidra, beroende på funktionerna du använder.
Det underlag modellen har tillgång till just då kallas kontext. Att chatten verkar minnas vad ni pratade om betyder alltså att tidigare information har gjorts tillgänglig för modellen. Ett sparat minne i appen är en annan sak än att modellens grundträning ändras när du skriver till den.
Utrymmet är begränsat av modellens kontextfönster. I långa samtal kan information behöva väljas ut, kortas eller sammanfattas. Hela historiken behöver därför inte följa med ordagrant. OpenAI beskriver hur samtalshistorik och kontextfönster hanteras.
Ett praktiskt exempel: Har ni diskuterat tre olika målgrupper och sedan ber om en annonstext kan underlaget bli otydligt. Samla den valda målgruppen, erbjudandet och önskat nästa steg i en kort instruktion. Då blir uppgiften lättare att följa.
Runt modellen kan det också finnas säkerhetskontroller som granskar indata och svar. Anthropic beskriver exempelvis klassificerare som ska upptäcka försök att kringgå skydd. Hur kontrollerna är ordnade varierar mellan tjänster.
Texten blir tokens
Modellen arbetar med tokens. En token kan vara ett helt ord, en del av ett ord, ett skiljetecken eller en annan teckenföljd. Ett program som kallas tokenizer delar upp texten och ger delarna numeriska ID:n. Inne i modellen används numeriska representationer i beräkningarna.
Samma mening kan kräva olika många tokens beroende på språk och tokenizer. Därför går det inte att säga att ett visst antal svenska ord alltid motsvarar ett visst antal tokens. OpenAI:s förklaring av tokens visar hur text delas upp.
Uppdelningen hjälper oss också att förstå varför bokstavsräkning och långa sifferserier kan vara besvärliga. Modellen får inte alltid ordet eller talet i den form vi föreställer oss. Tokenisering är en del av förklaringen, men säger inte ensam hur bra en modell är på språk eller matematik.
I datacentret bearbetas sambanden
För en molntjänst som ChatGPT sker modellens tunga beräkningar på servrar. Kraftfulla beräkningskretsar, ofta GPU:er, gör många matematiska operationer parallellt. Resurser kan delas mellan flera förfrågningar för att utnyttja kapaciteten bättre.
En central byggsten i många språkmodeller är transformerarkitekturen, som presenterades i forskningsartikeln Attention Is All You Need 2017. Där används attention för att väga samman information från olika positioner i en sekvens.
Ta ordet ”fil”. I meningen ”Jag laddade upp en fil” betyder det något annat än i ”Vi åt fil till frukost”. Orden runt omkring hjälper till att avgöra vilken betydelse som är relevant. Attention är ett sätt för modellen att bearbeta sådana samband, även över längre avstånd i texten.
Beräkningarna styrs av ett stort antal inlärda värden, parametrar. De formas under träningen och påverkar hur modellen reagerar på olika underlag. De fungerar inte som en katalog där modellen slår upp ett färdigt svar på varje fråga.
Svaret byggs upp en textdel i taget
När modellen ska skriva en fortsättning beräknar den sannolikheter för möjliga nästa tokens. Ett alternativ väljs, läggs till och påverkar fortsättningen. Processen upprepas tills svaret är färdigt eller når en gräns.
Det här är en förenklad beskrivning. System kan återanvända tidigare beräkningar och använda tekniker som snabbar upp genereringen. Modellen behöver alltså inte räkna om varje del av hela samtalet från början för varje ny token.
Att texten ofta växer fram på skärmen beror på att appen kan visa delar av svaret medan de genereras. Exakt när delarna visas beror också på hur tjänsten skickar och samlar dem.
Varför kan AI låta säker och ändå ha fel?
En språkmodell kan skapa en rimlig fortsättning även när underlaget inte räcker för ett korrekt svar. Då kan den fylla luckor med uppgifter som låter trovärdiga. Det brukar kallas hallucinationer.
Träning, instruktioner, resonemang och tillgång till källor kan förbättra svaren. En välskriven formulering är ändå inget bevis för att en uppgift stämmer. Det gäller särskilt sådant som kräver en aktuell eller exakt källa.
Tänk att ni ber om en presentation av företaget utan att ge något underlag. Modellen kan skriva om snabb leverans, särskilda certifieringar eller många års erfarenhet, eftersom det passar formen. Varje sådan uppgift måste komma från er verksamhet och kontrolleras innan texten används.
Skriv hellre: ”Använd bara uppgifterna i det bifogade underlaget. Markera det som saknas.” Be sedan om källor för faktapåståendena och kontrollera att källorna faktiskt stöder dem.
Resonemang och verktyg ger fler sätt att lösa uppgiften
Vissa modeller använder extra beräkning för att arbeta igenom en uppgift innan de lämnar ett svar. De kan pröva angreppssätt, planera flera steg och bearbeta osäkerheter. OpenAI beskriver detta som interna resonemangstokens. Det kan hjälpa vid svårare problem, men innebär ingen garanti för att slutsatsen blir rätt.
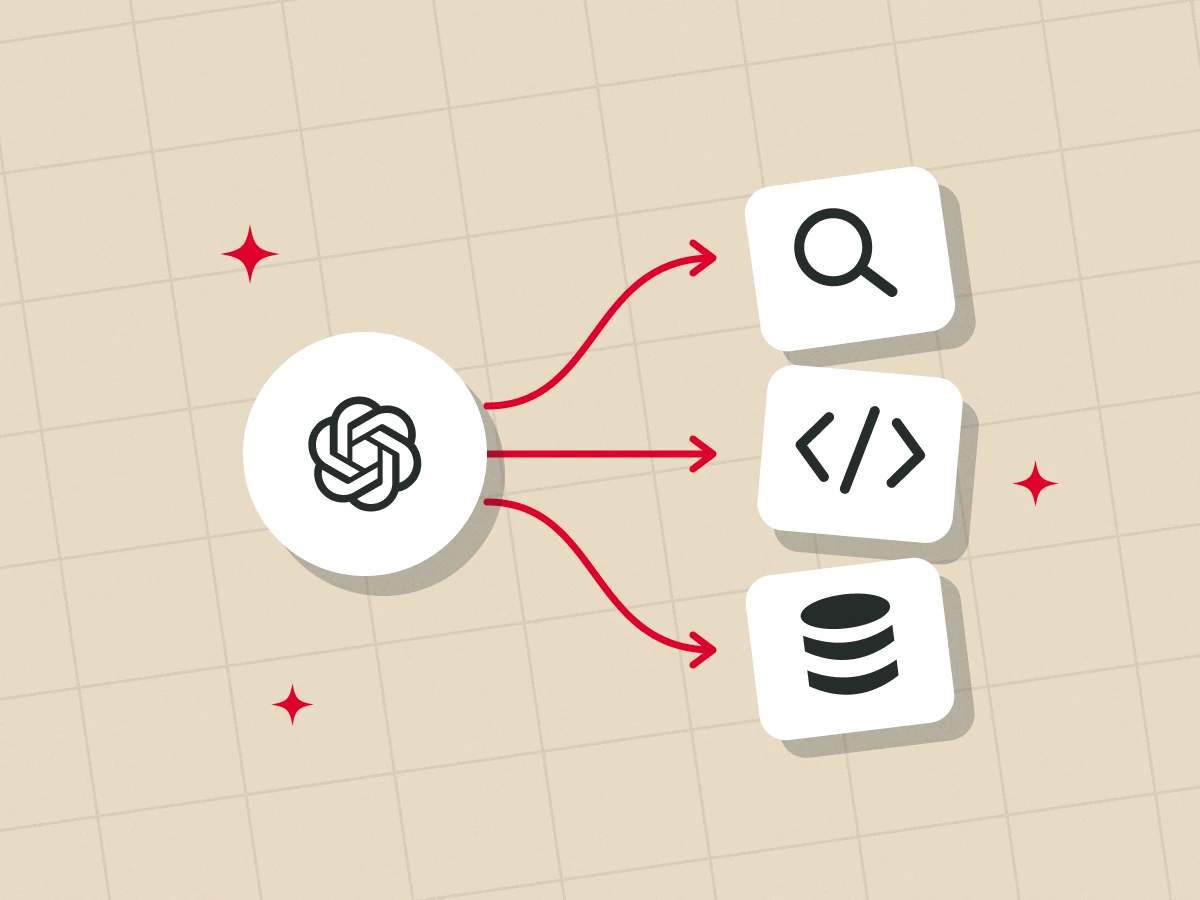
Modellen kan också få tillgång till verktyg. Ett sökverktyg hämtar webbinformation. Ett kodverktyg kan utföra en beräkning. En koppling till ett affärssystem kan hämta exempelvis en orderstatus, om lösningen har rätt åtkomst.
Modellen begär då att ett verktyg används. Programvaran utför uppgiften och lämnar tillbaka resultatet som nytt underlag. Därefter kan modellen svara eller begära ytterligare ett steg. OpenAI:s dokumentation om verktygsanrop beskriver det flödet.
Den skillnaden spelar roll när ett företag bygger en chatbot. Frågan ”Vilka öppettider har ni?” behöver en godkänd, aktuell källa. Frågan ”Var är min order?” behöver dessutom en koppling till rätt system och en kontroll av vilka uppgifter kunden får se. En instruktion till modellen skapar inte den kopplingen av sig själv.
Så använder du kunskapen i företagets vardag
När man ser delarna bakom svaret blir det lättare att välja vad som behöver förbättras. Ibland behövs en tydligare fråga. Ibland saknas rätt information eller en systemkoppling. Börja här:
- Beskriv uppgiften och mottagaren. Säg vad du vill få fram, vem som ska använda det och vilket format som behövs. Till exempel ett mejlutkast till en befintlig kund, med en tydlig fråga om nästa steg.
- Ge ett avgränsat underlag. Lägg med rätt produktfakta, villkor och exempel. Välj information som hjälper uppgiften, och använd material som ni får hantera i den valda tjänsten.
- Samla beslut när samtalet blir långt. Skriv vilka förutsättningar som gäller nu. Starta vid behov en ny chatt med ett kort underlag som du själv har kontrollerat.
- Använd rätt verktyg för exakta uppgifter. Aktuella uppgifter behöver aktuella källor. Beräkningar kan behöva kod eller kalkylverktyg. Kundspecifika uppgifter kräver rätt systemåtkomst.
- Bestäm vem som granskar resultatet. Låt en ansvarig person kontrollera fakta, ton och viktiga beslut. Om ett flöde ska automatiseras behöver ni också veta vad som händer när information saknas eller blir fel.
Det är också en bra utgångspunkt när ni bedömer en AI-lösning: vilken uppgift ska den lösa, vilka källor behöver den, vad får den göra och hur kontrolleras resultatet? De frågorna gör det lättare att bedöma nyttan för er verksamhet.
Vill ni gå vidare med en konkret uppgift kan ni läsa om vår hjälp som AI-konsult för företag. För ett annat perspektiv på tekniken finns också artikeln om hur hemsidan behöver fungera för kundens AI-agent.